
Кога има смисъл дълбокото обучение при оценяването на американски опции?

Доказателства от възпроизводим проект за сурогатно оценяване на американски пут опции

Резюме
Тази статия обобщава завършен проект по дълбоко обучение за оценяване на американски пут опции, изграден като възпроизводим изследователски процес и изцяло документиран в публичното GitHub хранилище, посочено в края. Основният въпрос не беше дали една невронна мрежа може да апроксимира цените на опциите — разбира се, че може — а дали дълбокото обучение добавя нещо, което един добре реализиран числен метод вече не предоставя. За да се провери това, проектът генерира синтетичен набор от 1,45 милиона наблюдения за американски пут опции чрез валидирано високорезолюционно биномиално дърво на Cox-Ross-Rubinstein (CRR), след което сравни няколко невронни архитектури както помежду им, така и спрямо самото дърво: директен многослоен перцептрон (MLP), модели на база премията и ограничени остатъчни модели, класификатор за упражняване, невронна политика за продължаване по Longstaff-Schwartz и интегриран multi-head модел.
Основният резултат е, че финансово структурираната остатъчна невронна мрежа съществено подобрява точността на оценяването, елиминира нарушенията на долната ценова граница и при пакетна обработка оценява по-бързо от многократното изчисление чрез дърво — но само в рамките на областта, върху която е обучена. По-широкият извод е условен, а не триумфален: дълбокото обучение има своето място като сурогатен модел при големи, повтарящи се оценъчни натоварвания в рамките на обучената област. То не е заместител на числените методи за оценяване и не печели по подразбиране само защото е дълбоко обучение.
Въведение
Американските опции са по-трудни за оценяване от европейските по една конкретна причина: те включват решение за оптимално спиране. На всяка дата, на която упражняването е възможно, притежателят трябва да сравни стойността от незабавно упражняване със стойността от изчакване. Това превръща оценяването на американски опции в изчислителен проблем още преди да стане проблем на машинното обучение. Именно тази постановка определи начина, по който беше структуриран проектът. Вместо дълбокото обучение да бъде използвано просто защото курсът е по дълбоко обучение, целта беше да се провери дали една финансово структурирана невронна мрежа може да научи валидирана функция за оценяване на американски опции с достатъчна точност, с достатъчно коректно отчитане на собствените си ограничения и с достатъчно изчислително предимство, така че използването ѝ като практически сурогатен модел да бъде оправдано в подходяща операционна среда.
Обхватът умишлено остана тесен — само американски пут опции. Това позволи експериментът да остане ясно идентифицируем, финансовите ограничения да бъдат дефинирани чисто и проектът да бъде съгласуван със съществуващата литература за supervised option pricing и optimal stopping. Реалните пазарни данни не осигуряват контролираното покритие, необходимо за подобен експеримент, поради което вместо тях беше използван тестван оценъчен механизъм за генериране на синтетични данни. Именно този компромис направи възможно обучението спрямо известна целева функция, като същевременно се запазиха точни етикети за цена, премия за ранно упражняване, стойност на продължаването и самото решение за упражняване.
Какво беше направено в проекта
Работата премина през девет Jupyter notebook-а и допълващ source-code package, като всеки етап надгражда предходния:
Theory notebook — дефинира финансовия проблем, разлагането на премията за ранно упражняване и изследователските въпроси, на които останалата част от проекта трябваше да отговори.
Pricing-engine notebook — валидира Black-Scholes и CRR оценяването, изследва поведението при сходимост и избра резолюцията на дървото, използвана за генерирането на основните данни.
Data notebook — генерира и провери окончателния синтетичен набор от данни: 1 000 000 основни наблюдения, 250 000 наблюдения, фокусирани около границата на упражняване, и четири out-of-domain stress набора от по 50 000 реда, или общо 1,45 милиона реда.
Notebook 04 — обучи директен MLP за прогнозиране на нормализираната цена на американска пут опция. Това е наивният базов модел, спрямо който се измерват останалите модели в проекта.
Notebook 05 — преформулира задачата като прогнозиране на остатъчната стойност над финансова долна граница, вместо директно прогнозиране на самата цена, и в крайна сметка създаде най-силния статичен ценови модел в проекта.
Notebook 06 — разгледа решението „упражняване срещу продължаване“ по два начина: чрез специализиран класификатор и чрез споделен модел за цена и упражняване.
Notebook 07 — сравни класическия Longstaff-Schwartz с невронен вариант на continuation policy в отделен експеримент, базиран на симулирани ценови траектории.
Notebook 08 — изгради интегриран multi-head модел, който чрез едно общо представяне генерира защитена цена, директна цена, стойност на продължаването и препоръка за упражняване.
Notebook 09 — обедини всички резултати, провери ги спрямо предварително дефинираните хипотези и отговори на основния бизнес въпрос.
Основният организационен принцип през целия проект беше численият метод да остане референтният слой, а дълбокото обучение да се третира като сурогатен модел, който трябва да докаже полезността си, а не тя да се приема предварително.
Фигура 1 — Статични модели за оценяване върху общия тестов набор. Ограниченият residual MLP с финансова долна граница е най-силният статичен модел за оценяване.

Фигура 2 — Модели за вземане на решение за упражняване върху общия тестов набор. Интегрираният warm-start exercise head има минимално предимство, но специализираният класификатор остава по-чистият избор, когато задачата е единствено да се предвиди решението за упражняване.

Фигура 3 — Експеримент за оценяване, базиран на симулирани ценови траектории. Класическият Longstaff-Schwartz се представя по-добре от невронния вариант в рамките на тази имплементация.

Основни резултати
Това, което прави тези резултати по-убедителни от много демонстрационни проекти тип „deep learning for finance“, е, че моделите не бяха сравнявани само по средна грешка. Те бяха тествани върху съгласувани тестови данни и оценявани едновременно по финансова валидност, качество на решението за упражняване, влошаване извън обучената област и време за изпълнение — четири отделни начина, по които един модел може да се провали.
Върху общия тестов набор constrained floor residual MLP от Notebook 05 се представи най-добре сред статичните ценови модели, със средна абсолютна грешка в цената от приблизително 0,010. За сравнение, директният MLP постигна около 0,078, а европейският Black-Scholes proxy, използван като наивен заместител за американска опция, около 1,34. Именно разликата между тези стойности е същинският резултат: не това, че невронна мрежа може да апроксимира цените на американски опции — това вече е показано в редица предходни изследвания — а че начинът, по който е формулирана целевата променлива, има много по-голямо значение от сложността на самата архитектура.
Ограниченият модел реши и друг проблем, който директният MLP не успя да избегне: нарушенията на долната ценова граница, при които наивната прогноза може да падне под вътрешната стойност на опцията. След като моделът е принуден да прогнозира остатъчна стойност над предварително зададена финансова долна граница, този проблем изчезва по конструкция.
Въпросът за решението за упражняване показа сходна картина, макар и с по-малка разлика. Най-високият F1 резултат беше постигнат от интегрирания warm-start exercise head, който изпревари само минимално специализирания класификатор, предназначен единствено за упражняване. На практика изборът зависи от конкретната задача: ако е необходима само препоръка дали опцията да бъде упражнена, специализираният класификатор е по-чистият вариант за внедряване; ако са необходими едновременно цена и решение за упражняване от един и същ модел, интегрираният вариант е по-разумният компромис.
Не всички експерименти дадоха положителен резултат и това трябва да бъде казано ясно. Path-based сравнението в Notebook 07 доведе до отрицателен резултат — класическият Longstaff-Schwartz се представи по-добре от невронния continuation-policy вариант, който показа както по-висока грешка при оценяване върху held-out данни, така и по-слабо поведение на интервалите. Следователно проектът не твърди, че добавянето на невронна мрежа към произволен метод за оценяване автоматично го прави по-добър. В някои случаи класическият метод просто печели.
Out-of-domain представянето е другата област, в която моделите трябваше да докажат устойчивостта си, и тук резултатите в голяма степен не бяха добри. Всеки от допустимите статични невронни модели се влоши съществено, когато беше приложен извън диапазона, върху който е обучен. Това не е аргумент моделите да бъдат отхвърлени, а причина те да се използват зад проверки за допустимия входен диапазон, с готов числен fallback за всичко извън обучената област.
На практика този диапазон вече обхваща достатъчно широки стойности на moneyness, матуритет, волатилност, лихвени проценти и дивидентна доходност, за да покрива нормални оперативни условия. Затова out-of-domain наборите е по-коректно да се разглеждат като stress tests, а не като реалистична прогноза за рутинно production използване.
Фигура 4 — Влошаване на грешката извън обучената област. Out-of-domain влошаването е съществено при всички допустими статични невронни модели.

Бизнес интерпретация
Най-силният практически аргумент в полза на сурогатния подход не е точността сама по себе си, а изчислителното предимство, което тази точност позволява. След като бъдат обучени, избраните статични невронни модели значително изпреварват многократното високорезолюционно оценяване чрез биномиално дърво при големи batch натоварвания. На машината, използвана за тестовете, както constrained residual моделът, така и интегрираният модел започват устойчиво да превъзхождат високорезолюционната Numba CRR имплементация на проекта при приблизително 1 000 оценки на задача и нагоре.
При един милион оценки constrained residual моделът приключва изчисленията за приблизително 2,4 секунди, спрямо около 18 секунди за CRR имплементацията на проекта, докато интегрираният модел достига приблизително 2,9 секунди.
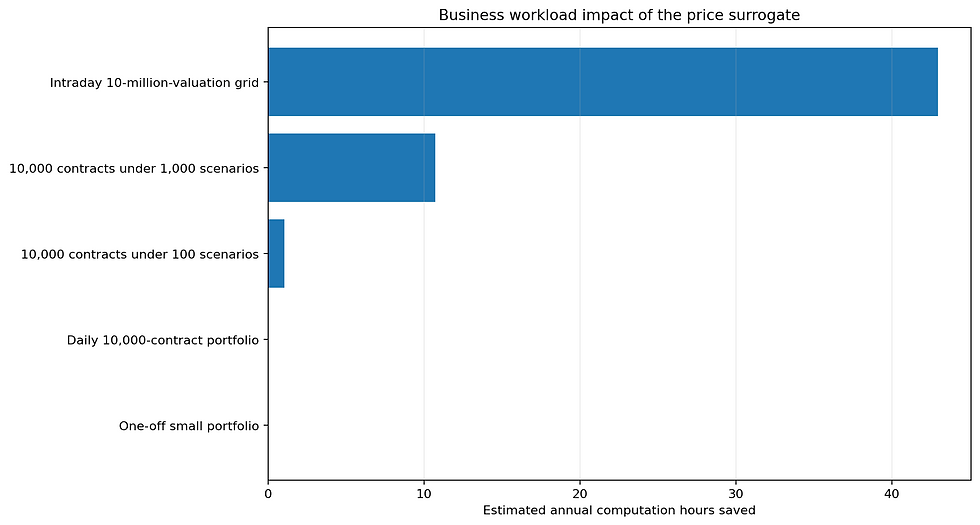
Това е реално ускорение, но има значение само в правилния контекст. При еднократна оценка или малък портфейл численият метод остава по-разумният избор — няма достатъчно голям batch, върху който да се амортизира разходът по обучението на модела. Практическата стойност се появява при големи и повтарящи се натоварвания: scenario grids, intraday risk systems, мащабни брокерски операции, market making при опции, институционално преоценяване на портфейли и потенциално high-frequency trading, където намаляването на latency има реална оперативна стойност.
Фигура 5 — Сравнение между избрания статичен невронен модел и високорезолюционния CRR на база време за оценяване на една опция. След обучението невронният сурогатен модел драстично намалява пределното време за оценяване.

Фигура 6 — Мащабиране на времето за изпълнение според използвания метод за оценяване. Невронният inference става относително по-привлекателен с увеличаването на размера на batch-а.

Фигура 7 — Ускорение спрямо CRR имплементацията на проекта. Невронните модели стават по-бързи при достатъчно големи изчислителни задачи.

Анализът на lifecycle break-even достига до същия извод от различен ъгъл и това е частта от проекта, която бих определил като най-полезна за всеки, който оценява твърдение за „AI ускорение“ в друг контекст. Невронният сурогатен модел може бързо да стане много ефективен по време на изпълнение, но създаването му не е безплатно — генерирането на етикети, обучението, валидирането и внедряването изискват време и ресурси предварително.
Разграничаването между runtime crossover — от какъв размер на задачата inference-ът става по-бърз от оценяването чрез дърво — и lifecycle break-even — кога натрупаното спестено време компенсира първоначалния разход по изграждането на модела — е това, което прави анализа по-коректен. Това са два различни въпроса и разграничението между тях лесно може да бъде пропуснато, когато някой се опитва да представи AI решението като автоматично по-бързо или по-ефективно.
Фигура 8 — Оценено годишно отражение на натоварването. Оперативният аргумент в полза на невронния сурогатен модел става съществен при големи и многократно повтарящи се обеми от оценки.
Фигура 9 — Lifecycle break-even при различни допускания за първоначалните разходи по изграждането на модела.

Заключение
Заключението тук е условно, а не идеологическо, и според мен именно това го прави по-полезно. Дълбокото обучение има смисъл при този проблем, когато функционира като финансово структуриран, in-domain слой за ускоряване на големи и повтарящи се оценки на американски пут опции. То няма смисъл като универсален заместител на числените методи за оценяване и не оправдава по-сложна архитектура само защото такава сложност е технически възможна.
Най-добре представилият се модел в целия проект не беше нито най-големият, нито най-сложният — това беше constrained floor residual MLP, който постигна най-добрите резултати чрез комбинация от финансова структура и по-просто формулирана задача за обучение, а не чрез добавяне на още параметри и капацитет към модела. Интегрираният модел оправдава използването си, когато цената и информацията за упражняване трябва да бъдат получени от един и същ модел. Невронният вариант на Longstaff-Schwartz, от друга страна, изобщо не успя да обоснове практически deployment — полезно напомняне, че „neural“ не означава автоматично „по-добро“.
Казано по-просто: дълбокото обучение може да създаде реална стойност при оценяването на опции, но само при определени условия — наличие на валидиран числен референтен метод, спрямо който моделът да бъде проверяван; ясно дефинирана оперативна област; достатъчно голям и повтарящ се обем от оценки, който да оправдае разхода по изграждането на модела; и финансови ограничения, заложени директно в неговата конструкция, вместо добавени впоследствие.
Това е по-тясно твърдение както от оптимистичния, така и от скептичния разказ за AI, но според мен е и по-точното.
Емпирична основа
Всички емпирични твърдения в тази статия са базирани на публичното хранилище на проекта и неговия финален evaluation workflow: github.com/Kamend1/deep_learning_american_option_pricing
Използвана литература
Black, F., & Scholes, M. (1973). The pricing of options and corporate liabilities. Journal of Political Economy, 81(3), 637–654.
Cox, J. C., Ross, S. A., & Rubinstein, M. (1979). Option pricing: A simplified approach. Journal of Financial Economics, 7(3), 229–263.
Ding, L., Lu, E., & Cheung, K. (2025). Deep learning option pricing with market implied volatility surfaces.
Elbayed, Z., & Qadi El Idrissi, A. (2025). Deep learning in financial modeling: Predicting European put option prices with neural networks.
Ke, A., & Yang, A. (2019). Option pricing with deep learning.
Longstaff, F. A., & Schwartz, E. S. (2001). Valuing American options by simulation: A simple least-squares approach. Review of Financial Studies, 14(1), 113–147.
Merton, R. C. (1973). Theory of rational option pricing. Bell Journal of Economics and Management Science, 4(1), 141–183.
Pimentel, R., et al. (2026). Option pricing with deep learning: A long short-term memory approach.
Pu, V. R. H. (2021). Pricing options using deep neural networks from a practical perspective.
Zouaoui, H., & Naas, M.-N. (2023). Option pricing using deep learning based on LSTM-GRU neural networks.